1-2. 傳統計算(ABC分析)與Tera計算的差異
在現代的物流設施計畫中,僅靠單純彙整過去的資料,是無法對日益高度化的物流中心進行最佳設計的。在Tera計算中,將長年在現場使用的傳統ABC分析依等級彙整手法稱為「傳統計算」。
本節將明確指出導致資料含義割裂的傳統ABC分析的極限,並深入解說為克服此極限而開發的Tera計算獨有的「EIQ矩陣彙整」差異點,以及為了導出更正確的設備規模計算的資料分析概念。
1. 傳統計算與Tera計算在基本概念上的差異
傳統計算(ABC分析)的極限與資訊的割裂
傳統的ABC分析,是從出貨實績中將品項彙整(暢銷・滯銷)與出貨地點彙整(大宗・零散)各自劃分為A・B・C 3個等級,並進行獨立彙整的手法。 這個手法適合用來查看各自的「結果分布」,且兩個表的心總計值會是一致的。
然而,最大的缺點是表格之間完全沒有關聯性(相關性)。 因此,無法掌握「品項等級為A的超級暢銷商品,是以多少的比例被分配到哪種出貨地點等級(是大型批發商,還是零散的個人客)」這樣立體性的結構。 若缺乏這項資訊,就無法準確測量揀貨區的適當面積,或是分揀機等自動化設備的導入效果,作為最佳的物流設施計畫或運用檢討的基礎資料是不充分的。
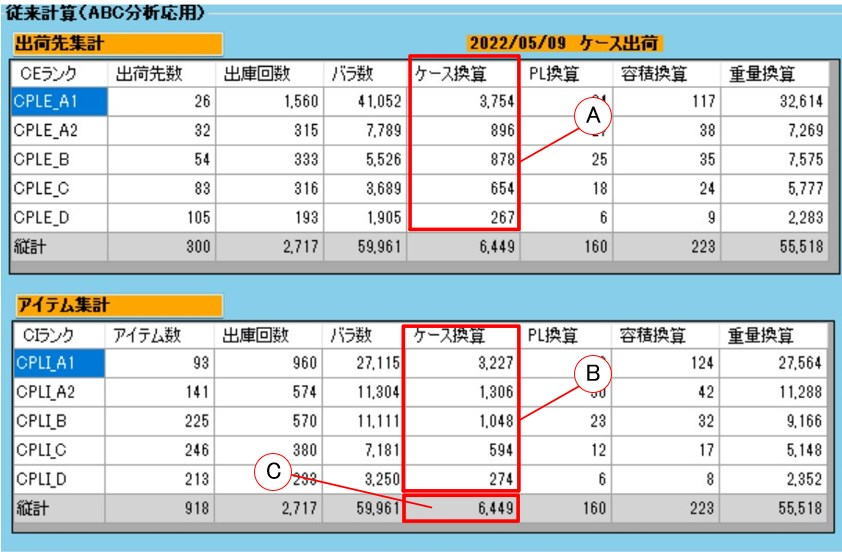
Tera計算的提案:使資料產生相關的「EIQ矩陣表」
在Tera計算中,為了解決這個「資訊的割裂」,採用了將等級擴展為更為細緻的5個劃分(A1, A2, B, C, D),並區分為 品項等級(5)× 出貨等級(5)= 25個區塊的網格狀,以進行交叉彙整・相關分析的手法。 這被稱為「EIQ矩陣表」。
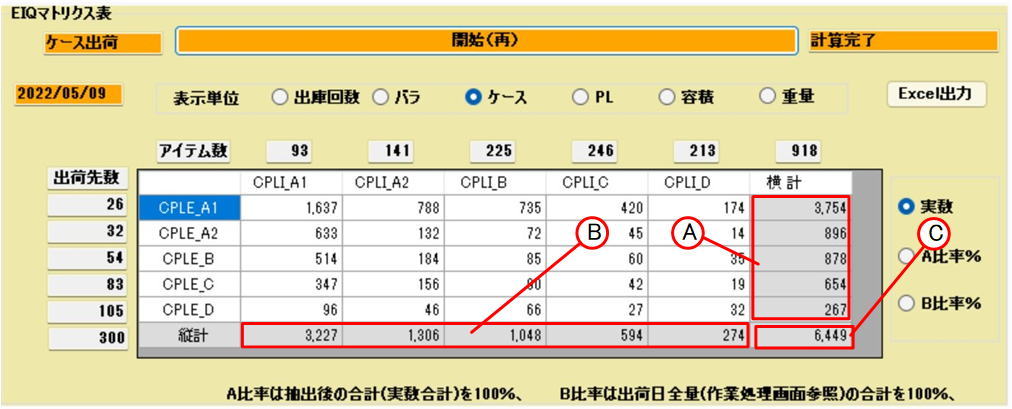
其最大特色在於,在同一個等級區分內,可以自由切換顯示「行數(出庫次數)」、「零散數(件數)」、「箱換算」、「PL(棧板)換算」、「容積換算」、「重量換算」等在物流現場不可或缺的指標。 藉此,能夠將各個作業區域所需的物流量(例如:在哪個區域會發生多少次揀貨、補貨需要多少箱數、搬運需要多少棧板數等)立體地視覺化,實現精準度極高的模擬。
2. EIQ矩陣彙整表與圖表化的重要性
第1項 EIQ矩陣彙整表的角色與可讀性的提升
- 顯示單位的換算規則與整合性的確保:
EIQ矩陣中顯示單位的箱、PL、容積、重量,全都是從作為基準的「零散數(件數)」計算出來的換算值。 因此,矩陣表的橫向總計會始終與傳統計算的「品項彙整」連結,縱向總計則與「發送地點彙整」連結,完美地確保了整體資料的吻合(整合性)。
- 透過龐大資料的群組化實現直覺性理解:
原始的生EIQ表(例如,發送地點400件 × 品項4000種等),會龐大到即使使用試算表軟體也無法捲動完畢,人類的眼睛無法解讀出趨勢,可讀性會顯著下降。 Tera計算將其群組化為5×5的等級(EIQ矩陣表),提高了實用性,使得經營階層或現場作業員都能一眼掌握狀況。 此外,還可以輸出為能在畫面上視覺性確認分布散落情形的「EIQ散布圖」,支援直覺式的分析。
第2項 設備規模計算中「Tera設定」的重要性
在選定物流設備時(例如決定分揀機等每小時的處理能力),為了防止瓶頸發生,通常會參考尖峰時段的物流量。 然而,在決定建築物面積或保管貨架總數的配送中心設備規模計算中,應該採用不偏向特定日期的「出貨資料整體平均(Tera設定)」,這是本研究所的鐵則。
- 避開特定尖峰日的理由1(全品項的網羅性): 如果只截取特定的出貨日來進行計算,剛好在那天沒有出貨的品項(如長尾商品等)資訊就會遺漏,導致倉庫整體的流動性評估或保管效率評估發生嚴重扭曲。 只要是以所有資料為對象(Tera設定),就能精確地網羅所有品項的動向。
- 避開特定尖峰日的理由2(防止過度投資): 出貨尖峰時異常增加的物流量,原則上是透過從安全庫存提前出庫,或是增加人力的運用來進行暫時性吸收處理,這是物流的基本。 如果以此為基準來進行物流設施計畫,將會導致中心本體的建築面積或固定設備規模過剩(Over-spec),為了防止在淡季持續支付無謂的折舊費用,必須避開此做法。
第3項 時間・路線・區分資訊的彙整反映
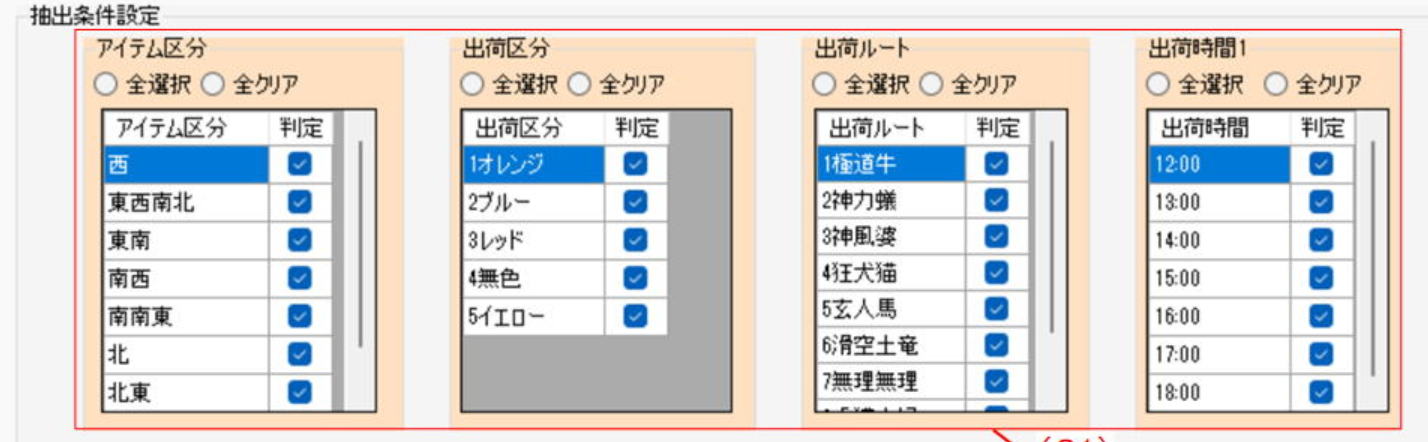
為了規劃更貼近現場的物流設施計畫,在EIQ矩陣的彙整中也會反映以下的詳細屬性資訊。
- 出貨時段(1小時區分): 視覺化結單時間前的訂單集中程度,運用於判斷是否可進行提前作業,以及基於各時段物流量來制定卡車有效率靠港安排的排程(月台預約)。
- 出貨路線: 運用於自家車隊的依方向(北區・南區等)群組指定,或是預測各運輸公司・路線班車・宅配業者的裝載月台分揀作業量,以防止月台的擁塞。
- 出貨區分・品項資訊: 用於掌握各出貨地點要求的樹脂物流箱/紙箱等包裝指定,或是流通加工(貼標籤、貼標價)・品質檢查等,在進出貨時發生的特殊作業條件與所需空間。
3. EIQ矩陣彙整表的運用應用例
第6項 透過EIQ矩陣進行揀貨策略的最佳化
在將發送地點及商品依照物流量多寡矩陣化後,如何將這些數值轉換為實際的運用規則,便是展現技術之處。 例如,透過資料分析的結果,如果能萃取出「0.5板以上/PIC(一次揀貨發生的量)」的物流量群組,便將其定義為「棧板出貨」。
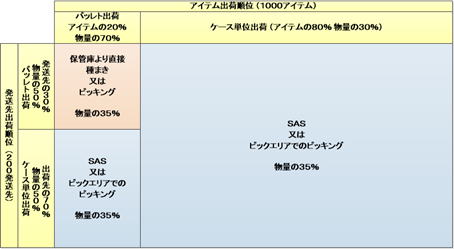
這個身為大宗的棧板出貨群組,如果特地拿到針對小批量的SAS(依序出庫系統)或一般揀貨區進行拆分處理,反而會增加動線與手續,導致效率顯著下降。 因此,可以邏輯性地判斷出,在確保寬敞通道的播種區(分揀區),使用堆高機等一次性處理2〜3個發送地點的份量(總量揀貨後再分揀)是最佳的。 另一方面,則可以劃分出其他的零散群組適合在SAS或標準的步行揀貨區進行保管與出庫。
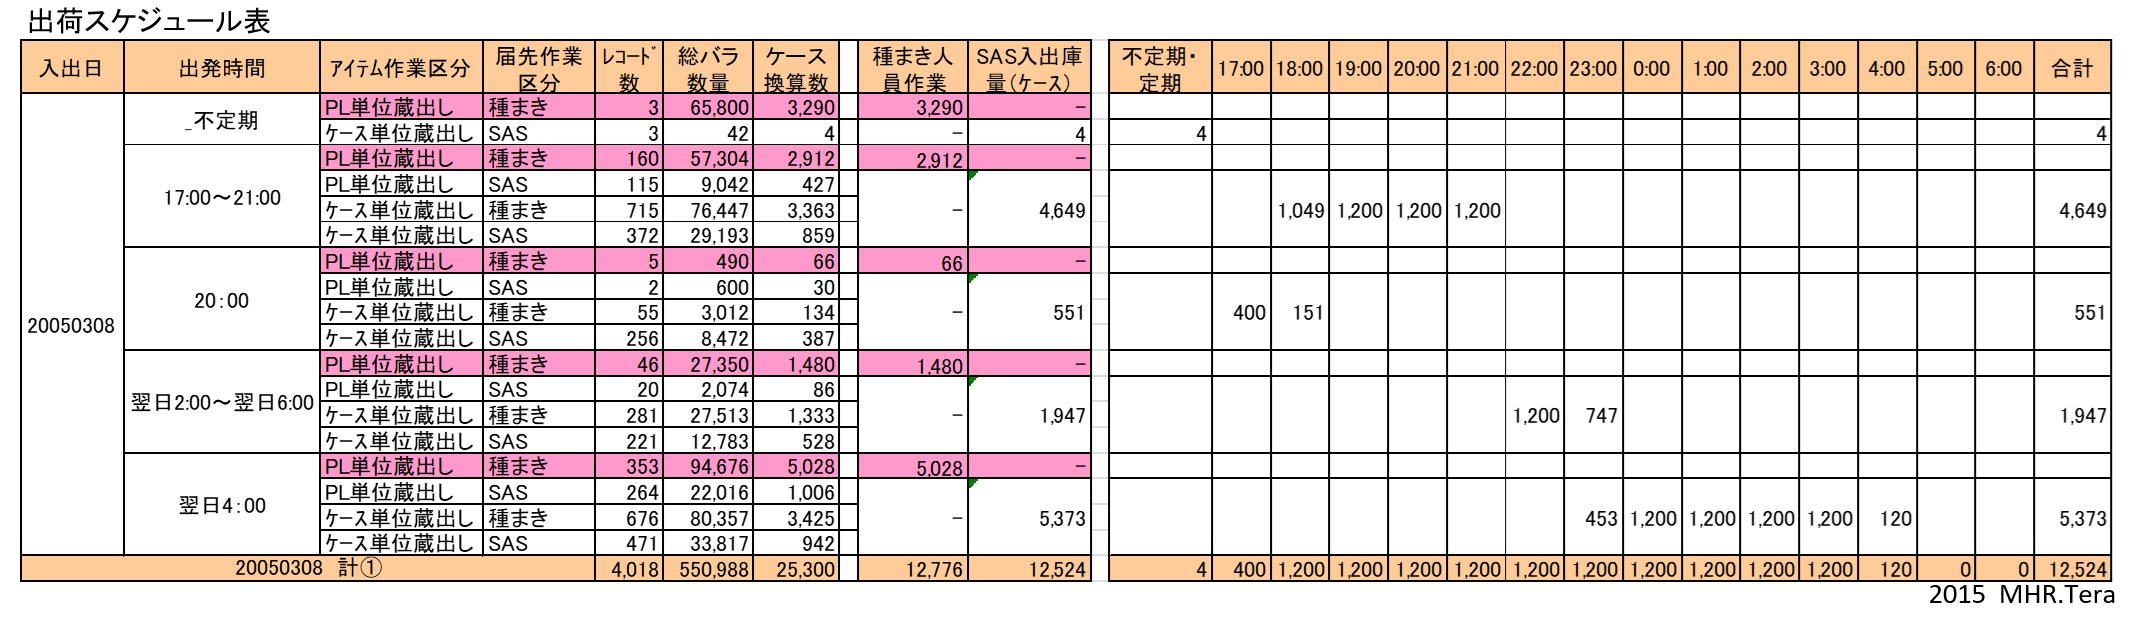
透過這樣運用EIQ矩陣表,不僅止於單純的現況分析,還能精確算出應該在何時將什麼品項補貨到哪個揀貨區(如SAS等)的時機,以及各區域所需的物流箱數量,並將其落實到每日實用的作業排程表中。 這個過程的積累,將結出沒有浪費的設備規模計算的果實。