物流AI「Tera計算 EIQ_AI」畫面圖解與功能解說
Tera計算 EIQ_AI 是一套以過去出貨數據為基礎,運用機器學習進行未來預測的物流AI系統。
系統能建立並訓練作為物流模擬基礎的模型資料,並利用已訓練模型進行 AI 預測與模擬分析。
在此頁面中,將為您逐一解說各個畫面的功能與運作機制,讓使用者能更直觀地理解整套系統的價值與邏輯。
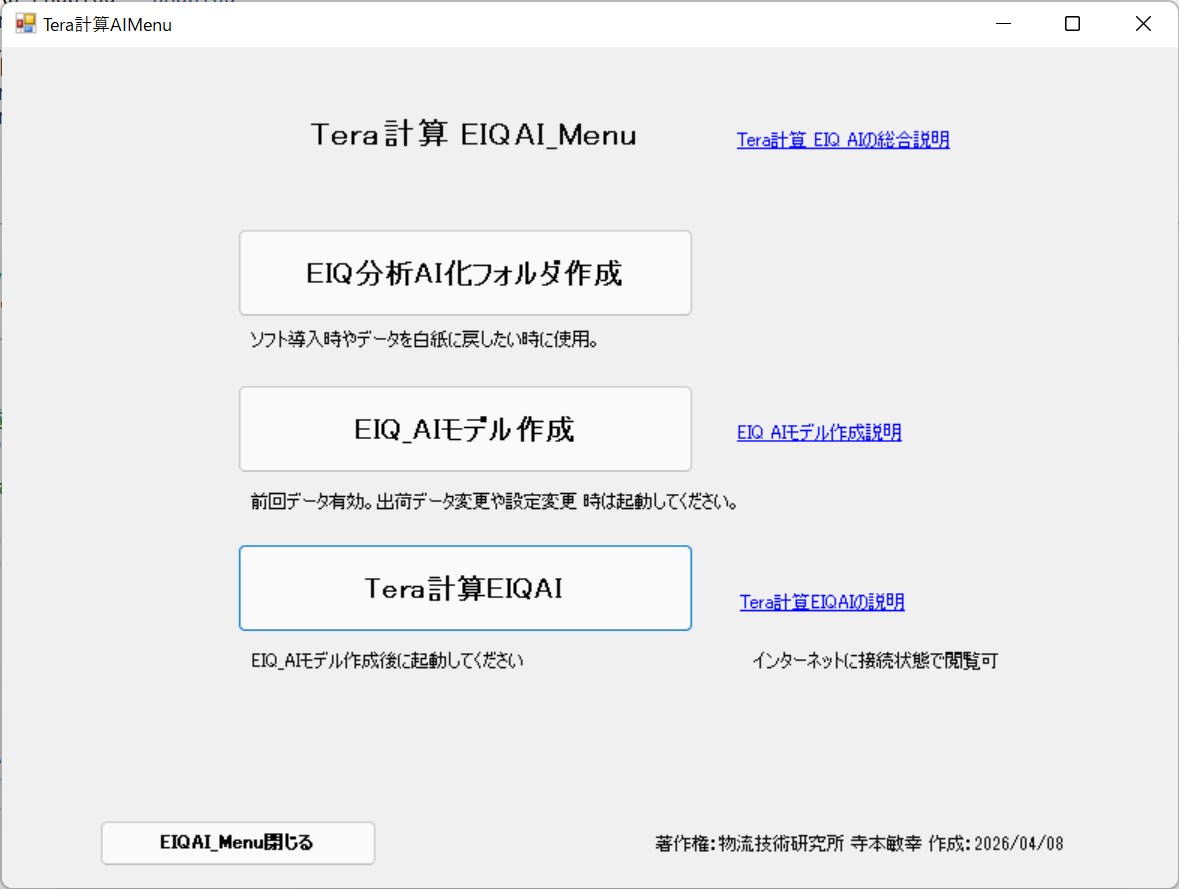
建立機器學習用模型資料的主選單畫面
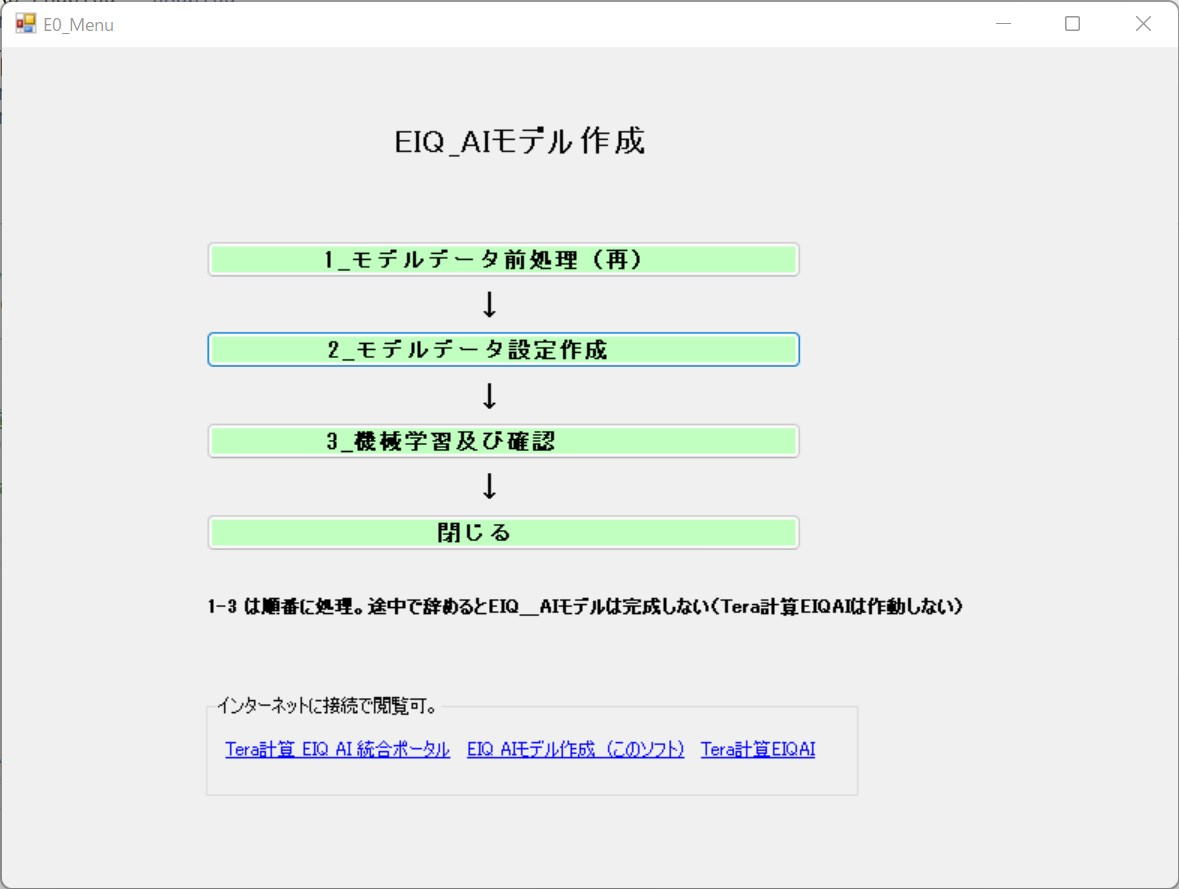
解說:
這是用來建立物流AI學習所需「模型資料」的起點畫面,整體設計簡潔且直觀。
從這裡可依序載入歷史出貨數據、設定 AI 訓練參數,並進入後續的計算與處理流程。
本畫面是整個系統的控制中心,讓第一次接觸物流模擬的使用者也能快速掌握操作順序。
使用者只需依序點選對應功能,即可為高階 AI 預測做好準備。
讀入作為模型基礎之出貨數據的畫面
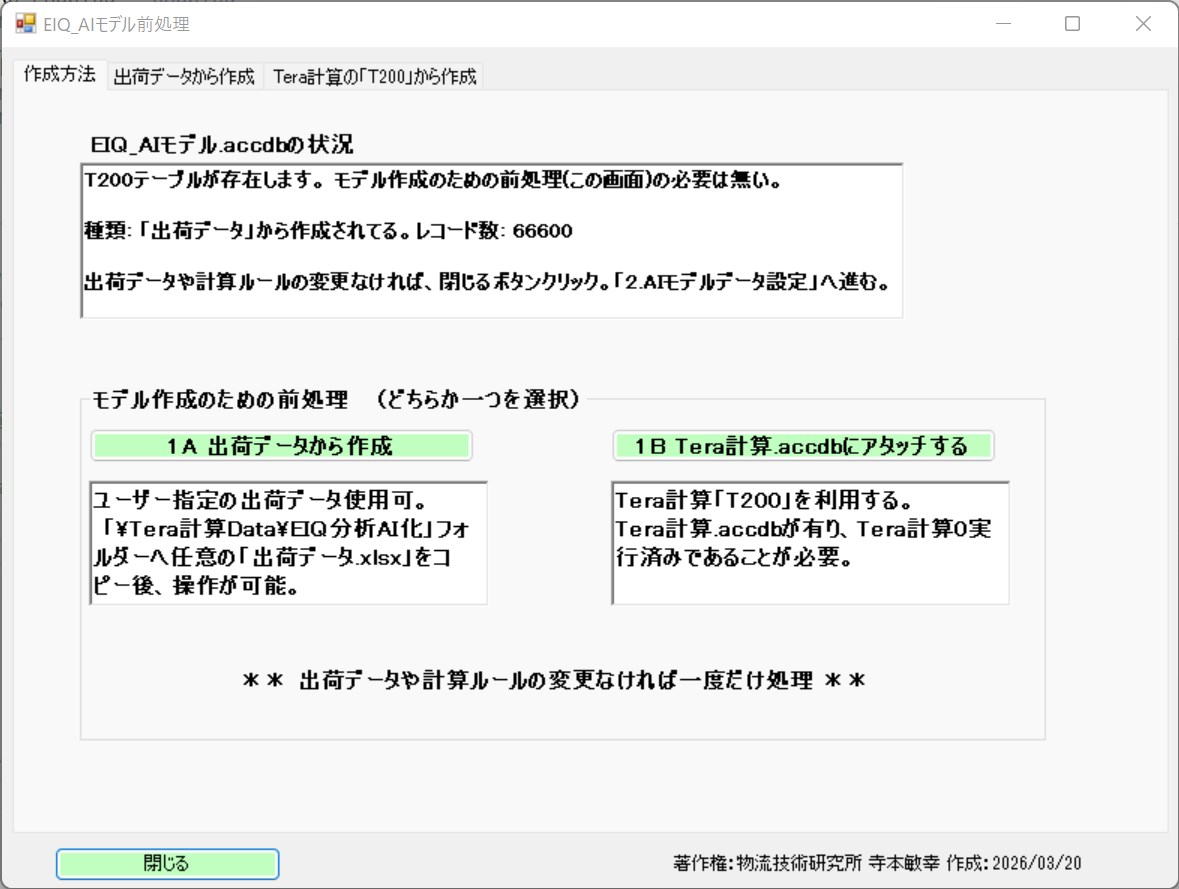
解說:
這是將作為機器學習基礎的歷史出貨數據(CSV 或 Excel 格式)匯入系統的畫面。
於此處匯入的原始數據,將成為精準預測未來物流波動的「訓練資料種子(Seed)」。
系統會檢查匯入內容,並自動整理成適合 AI 處理的乾淨資料格式,提升後續訓練效率。
透過實際業務中累積的真實資料,可以更貼近現場實務,建立更符合公司特性的高精度物流模擬。
從出貨數據建立模型資料的範圍與模型數量設定畫面
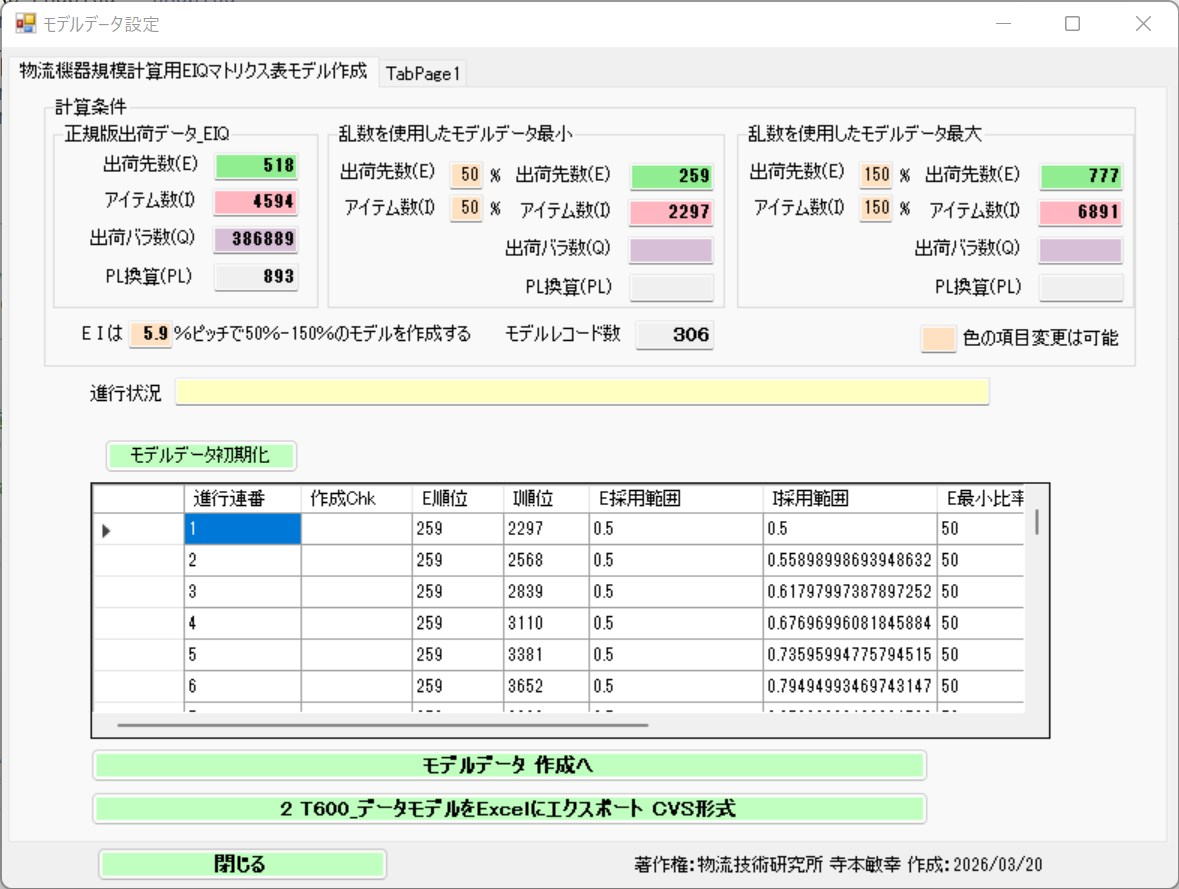
解說:
這個畫面用於依據匯入的出貨數據,設定模擬資料生成的範圍與粒度,例如 E/I 比例 50%~150% 等參數。
這不只是學習歷史數值,而是刻意模擬送達地址數(E)或品項數(I)發生極端增減時的「虛擬未來情境」。
透過彈性設定,系統可從單一出貨資料擴充生成數千種模式的預測模型,讓物流AI能學習各種可能情況,從淡季到異常繁忙期皆涵蓋在內。
從出貨數據建立模型資料的計算規則設定畫面
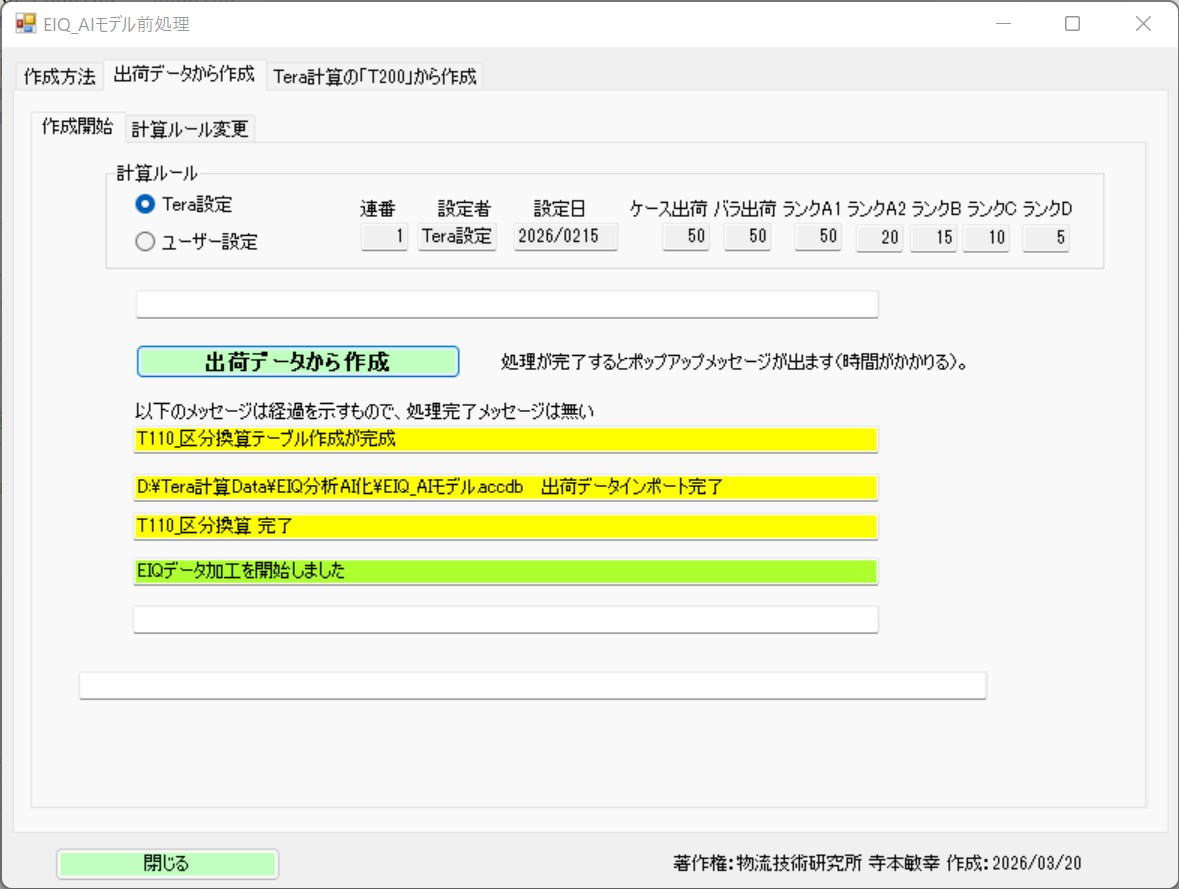
解說:
這裡不是直接讓系統學習原始出貨數據,而是定義專屬的計算規則,讓物流AI能準確辨識現場模式與關鍵特徵。
使用者可設定基於柏拉圖分析的 ABC 等級門檻,以及散裝、整箱等包裝型態的換算規則。
經過這道前處理後,原本只是數字排列的實績資料,將轉換成具有明確意義的高品質模型資料,更貼近現實營運狀況。
正在建立物流模擬用模型資料的處理畫面
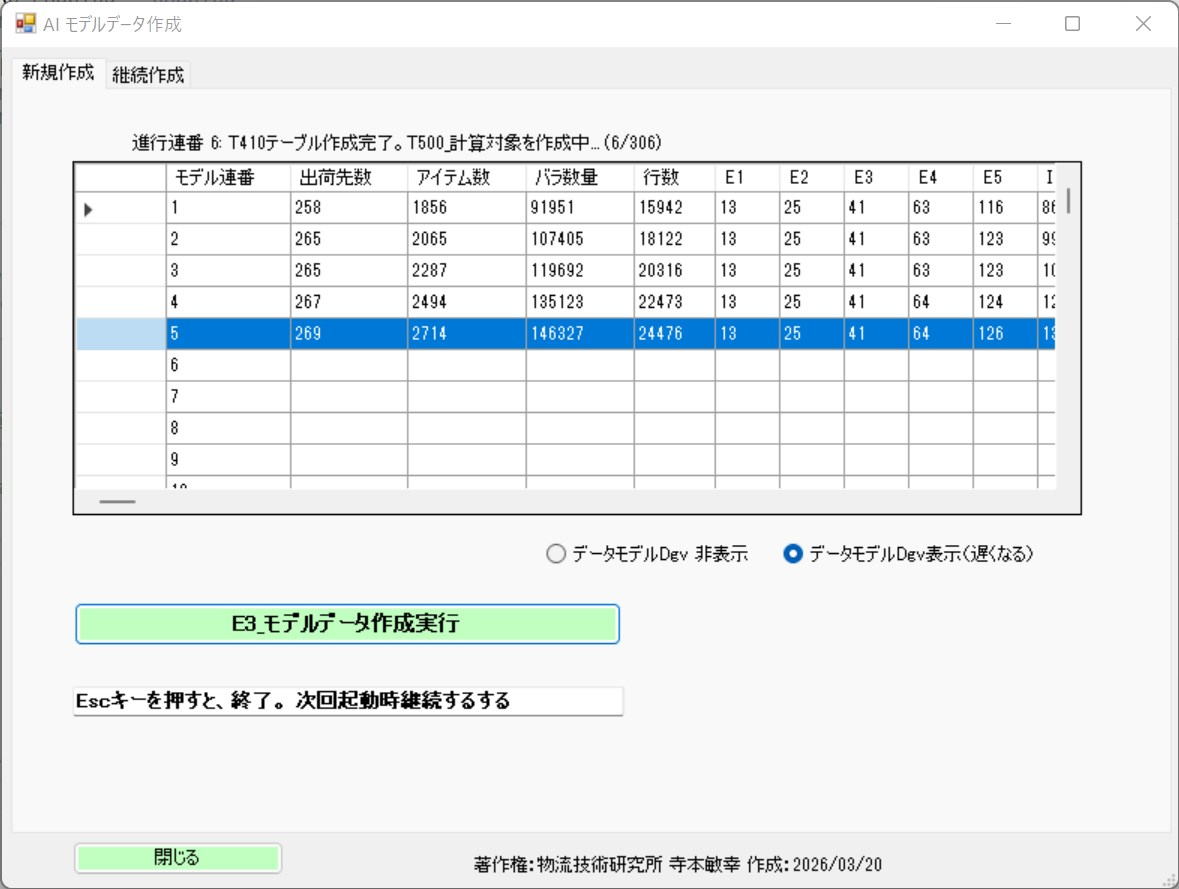
解說:
這個畫面會依照先前設定的情境條件與計算規則,自動生成供機器學習使用的模型資料(T600 資料表)。
系統會高速計算每筆資料中多達 165 個欄位(如散裝、整箱、容積、重量等各等級數值),並以進度條即時顯示執行狀態。
此外,也具備中途中斷與重新啟動的恢復功能,讓在建立複雜物流模擬空間時,仍能有效管理系統負載與執行時間。
對建立好的模型資料進行機器學習的畫面
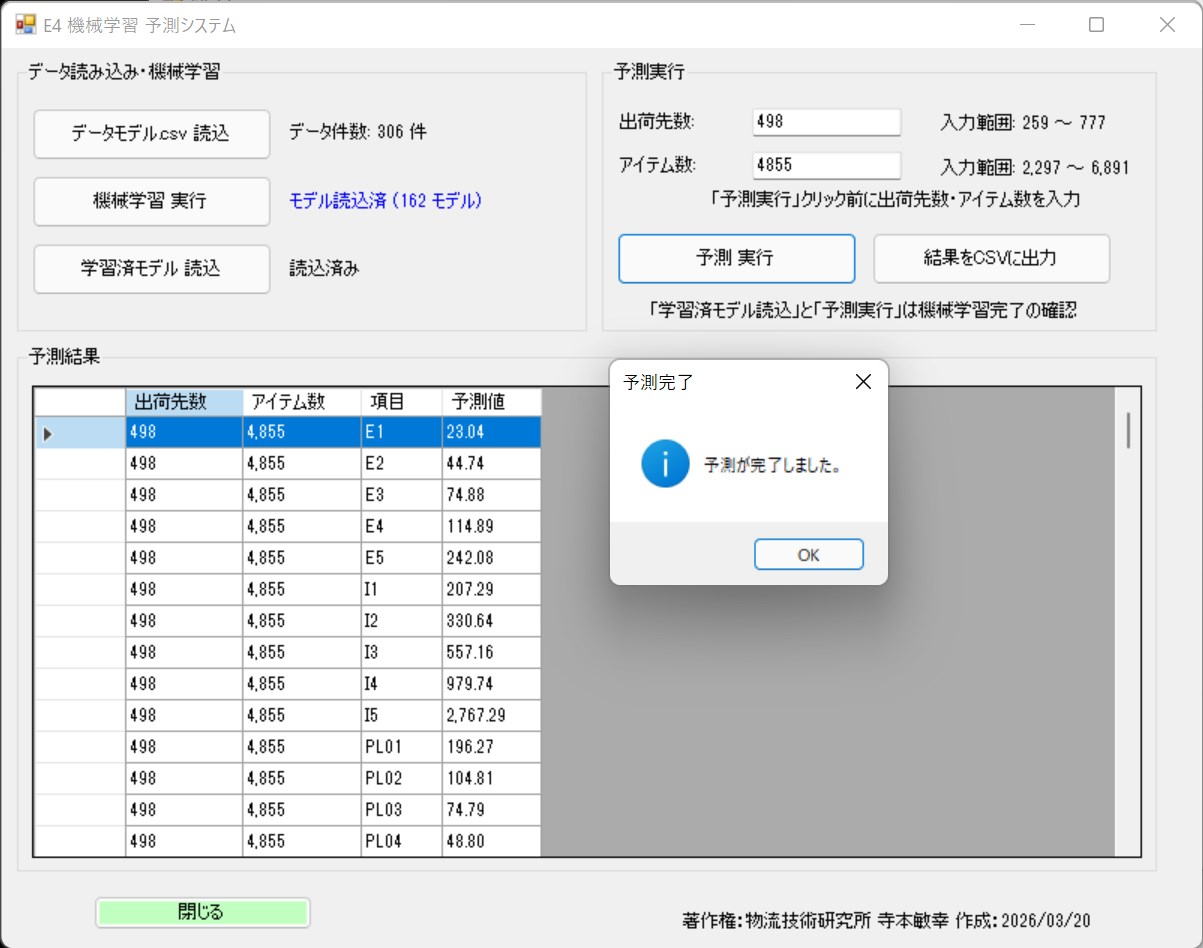
解說:
這是實際讓物流AI(機器學習引擎)學習大量生成模型資料的核心畫面。
系統採用 Microsoft ML.NET 內建的 SDCA 迴歸演算法,針對超過 160 個預測輸出變數同時建模,逐步形成各自的 AI 模型。
當學習完成後,AI 將掌握隱藏在出貨數據中的碎形法則,使系統在輸入未知資料時,也能快速產生高精度預測結果。
將物流AI模擬預測數值顯示於 EIQ_AI 表的畫面
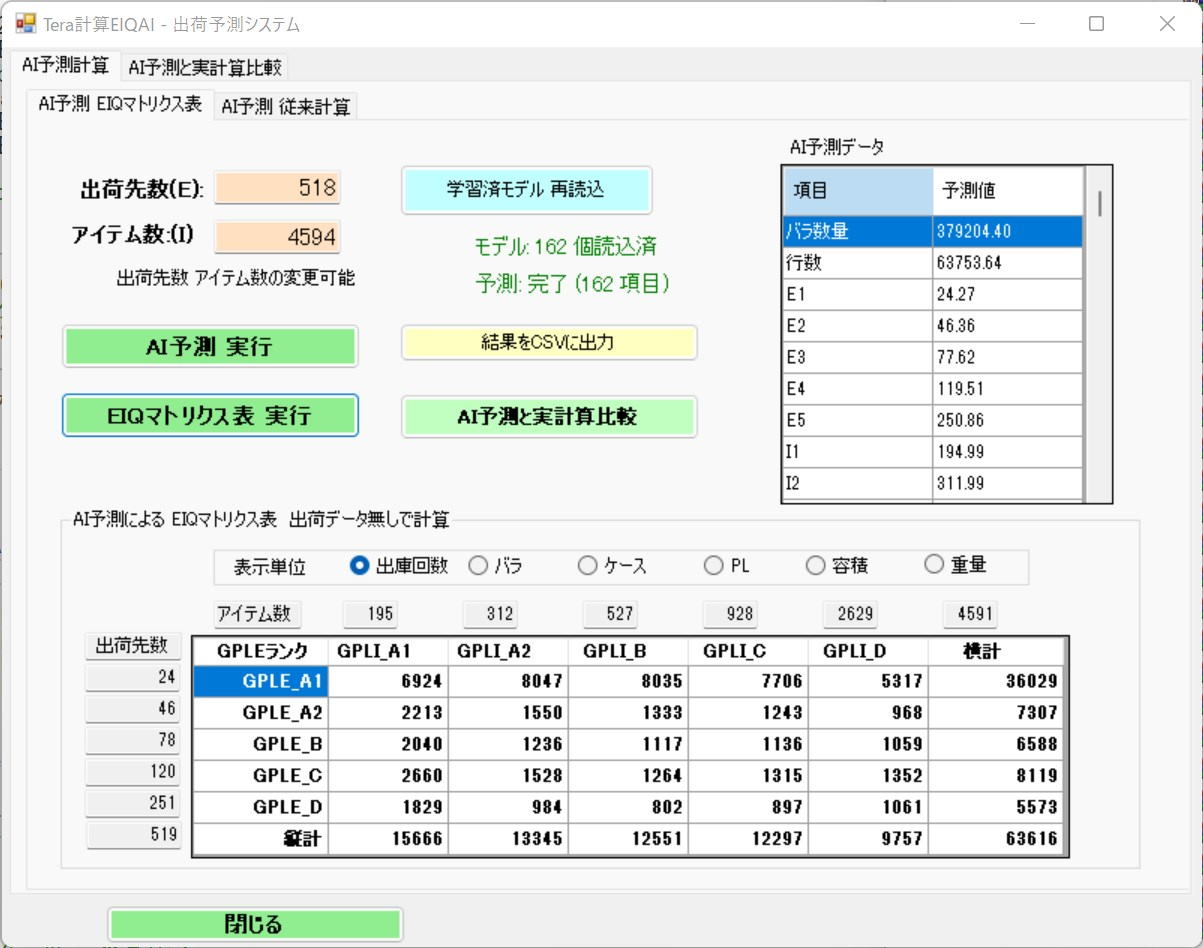
解說:
在機器學習完成後,使用者只需輸入任意的 E(出貨地點數)與 I(品項數),AI 即會即時算出未來物流模擬結果,並以「EIQ_AI 表(矩陣)」形式呈現在畫面上。
面對據點擴大、併購或災害等特殊情境時,使用者可以一目了然地確認各個 ABC 等級區域會產生多少作業行數、容積與重量等預測值。
這讓過去依賴直覺與經驗的中心設計與人員配置,得以轉化為更具邏輯與數據支持的決策方式。
驗證物流AI預測數值精度的畫面(顯示預測與實際計算)
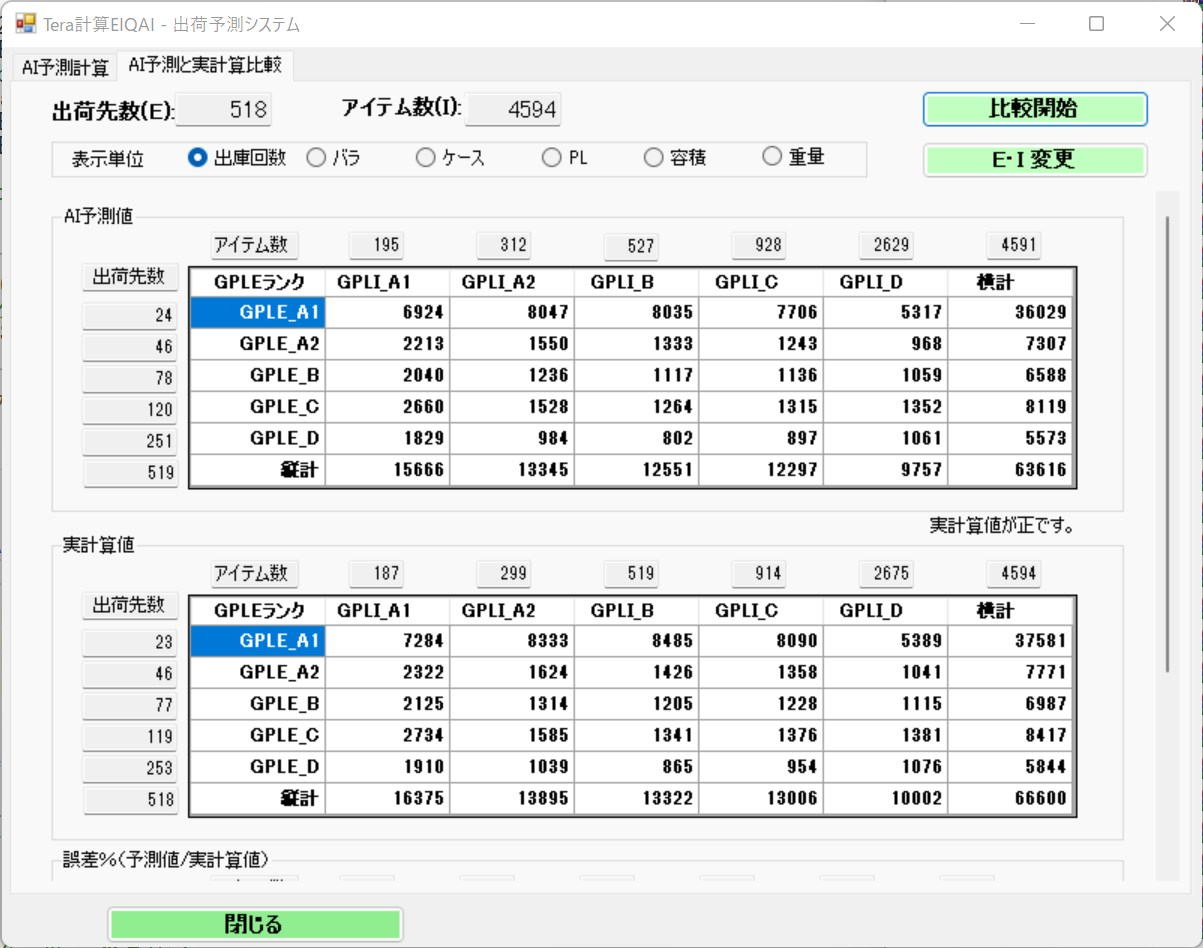
解說:
這個畫面用於評估所建立的物流AI模型是否在實際現場具備可靠精度。
系統會將原始出貨數據經過實際計算後得到的「實際值(正解數據)」與 AI 即時預測的「預測值」並排展示,便於直接比較。
透過此畫面,使用者可以判斷模型是否能穩定追蹤出貨地點數與品項數的變化,進而確認碎形特性的維持程度與結果的可信度。
驗證物流AI預測數值精度的畫面(顯示實際計算值與誤差)
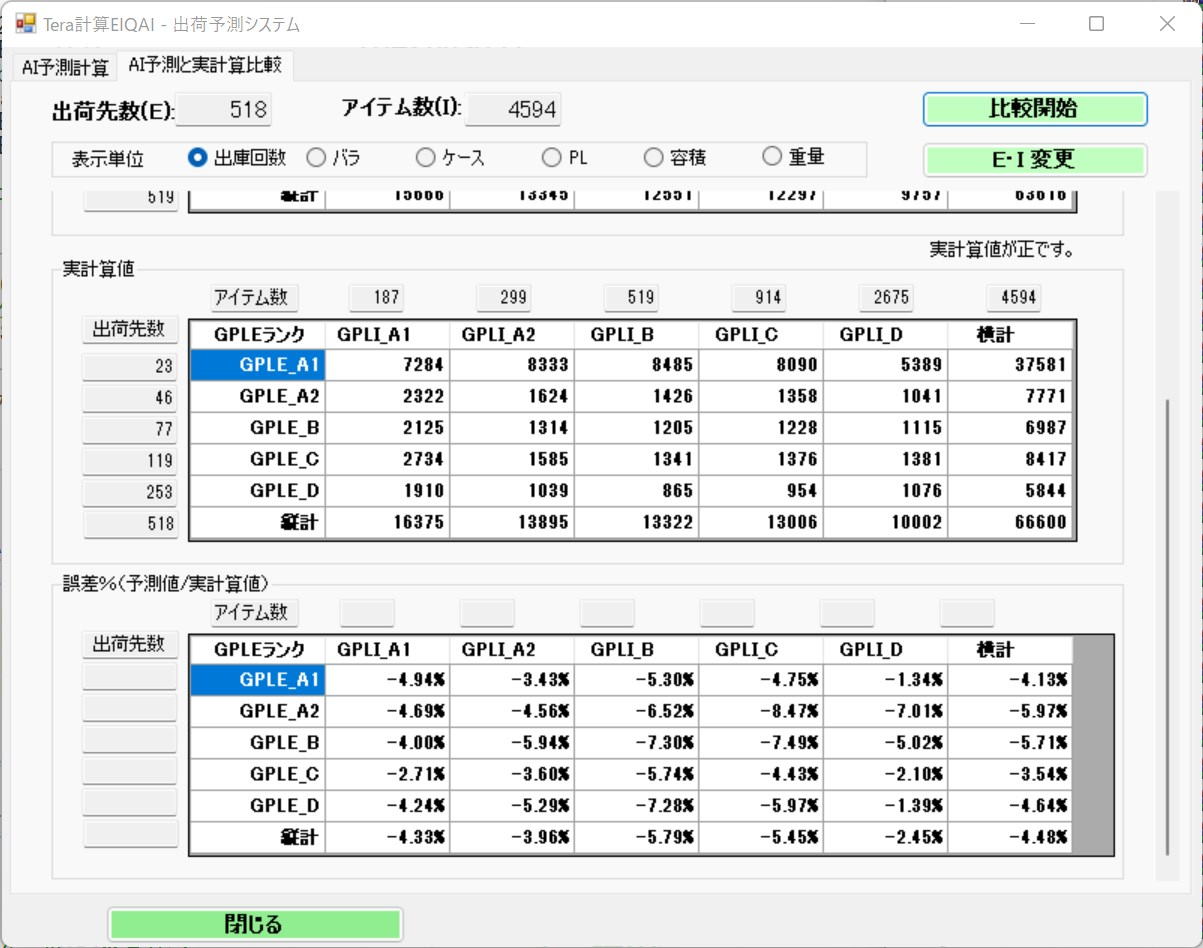
解說:
為進一步確認精度,此畫面會將物流AI預測值與實際計算值之間的誤差(偏差)以數值或圖表方式視覺化。
由於機器學習(SDCA 迴歸)的演算法特性,會產生與非線性乘法曲線相關的線性預測偏差,因此系統會特別觀察並校正這類落差。
在適當的修正係數(例如 1.14 倍等)套用後,預測結果可更接近實務現場需求,並形成真正可用於設計與規劃的高實用性物流模擬數值。