物流AI「Tera計算 EIQ_AI (EIQAI)」與物流模擬的機制
1.概要與開發目的
Tera計算 EIQ_AI(EIQAI)是一套軟體,旨在說明將物流AI(機器學習)引進傳統物流分析(EIQ分析),並活用碎形(Fractal)理論進行高精度物流模擬的方法與步驟
主要學習內容如下
- 從出貨數據建立模型數據的方法
- 對模型數據進行機器學習的方法
- 運用機器學習執行配送中心物流模擬(預測)的方法
- 驗證機器學習計算結果與實際計算誤差的方法
我們免費提供用於學習上述內容的軟體(Tera計算 EIQ_AI)
I. 物流AI「Tera計算 EIQ_AI (EIQAI)」與碎形理論概要
Tera計算 EIQ_AI(以下簡稱EIQ_AI)著眼於「出貨物會隨著出貨數據的出貨地點數(E)與品項數(I)之增減而呈碎形變化」的數據結構。
透過改變 E 與 I,建立 200 種集計了 161 項變數的模型數據模式,並進行機器學習(SDCA迴歸)。藉此,可學習因應 E 及 I 的變化來預測 161 項變數數值的物流模擬方法。
II. 作為學習軟體的效益
- 透過使用 EIQ_AI 軟體,能運用身邊的出貨數據學習物流AI模型的建立方法與步驟。
- 在實務應用上,由於計算完全在公司內部伺服器完成,可完全防止出貨數據(機密數據)外洩。
III. 課題與看法
- 模型數據的建立方法仍處於摸索階段,尚未達到完美成熟的境界。
- 物流模擬的適用範圍僅限於提供出貨數據的該配送中心,其他行業需另行建立模型數據。
- 計算值(出貨量)會因增減 E・I 的設定規則而產生差異。目前物流模擬採用蒙地卡羅法(Monte Carlo method)。
- 目前正在進行模擬值與實際計算值的誤差驗證。規模小於原始出貨數據的模擬精度良好,但規模變大時精度會變差,此為當前課題。
專有名詞解說(摘自 Google Gemini)
何謂碎形(Fractal)
由法國數學家班諾・曼德勃羅(Benoît Mandelbrot)提出的幾何學概念,指的是一種擁有「放大圖形的一部分,會重複出現與整體相同形狀」之神奇性質(自相似性)的結構。 這不僅僅是數學世界的議題,更是隱藏於自然界各處、非常美麗且有趣的概念。
- 💡 碎形的最大特徵:「自相似性」
理解碎形最關鍵的關鍵字是「自相似性」。這指的是像俄羅斯娃娃一樣,「無論微觀放大到何種程度,與巨觀整體極為相似的形狀都會無限連續出現」的狀態。 - 🌿 自然界與身邊的碎形例子
- 羅馬花椰菜: 最能直觀體現碎形的蔬菜。小花蕾呈螺旋狀聚集組成一個整體,而放大觀看該小花蕾時,會發現其呈現完全相同的螺旋形狀。
- 雪花結晶: 放大六角形分支的末端,會出現更小的六角形分支。
- 樹木分支與葉脈: 從粗幹分出樹枝、樹枝再分出細枝的結構,無論是從整棵樹來看,還是從單一樹枝來看,都呈相似形狀。
- 人類血管與肺部支氣管: 在有限的體積(體內)中,為了儘可能擴大表面積以高效輸送氧氣與血液,採用了碎形結構。
- 谷灣式海岸(海岸線): 從高空遠眺海岸線的形狀,與放大至100公尺見方觀看的形狀,兩者皆呈同樣複雜的鋸齒狀,難以區分。
何謂 SDCA 迴歸(Stochastic Dual Coordinate Ascent Regression)
這是一種主要用於對大規模數據集進行快速且高效學習的線性迴歸最佳化演算法。特別是在 Microsoft 的機器學習框架 ML.NET 中,作為標準且強大的迴歸演算法(SdcaRegression)提供,是相當常見的專有名詞。
- 💡 SDCA 的機制(名稱由來)
- Stochastic(隨機): 並非一次使用整個數據集進行計算,而是針對隨機選取的單一數據點更新參數。藉此節省計算所需記憶體並提升處理速度。
- Dual(對偶): 並非直接求解機器學習原本的最佳化問題(主問題),而是轉換為數學上等價的「對偶問題」來求解。對於帶有 L2 正則化的線性模型,轉換為對偶問題可使計算更簡單高效。
- Coordinate Ascent(座標上升法): 並非同時移動所有參數進行最佳化,而是高速重複「固定其他變數,僅針對單一變數(座標)進行精準最佳化」的操作,逐步逼近正確解答。
- 📌 SDCA 迴歸的優點
- 學習收斂極快: 相較於一般的隨機梯度下降法(SGD),特別是在數據筆數極多時,能以較少的計算次數達到最佳模型(低誤差狀態)。
- 無需調整學習率(Learning Rate): 在許多深度學習與機器學習演算法中,「學習率」的微調極為嚴苛,但 SDCA 能直接計算出數學上的最佳步長,因此能減少繁瑣的超參數調整。
- 強於大規模數據: 記憶體效率佳,即使特徵量(欄數)或數據列數多達數十萬至數百萬筆,效能也不易降低。
- ⚠ 缺點與注意事項
- 不適合複雜的非線性數據: 基本上是專為「線性模型」設計的演算法。若數據間的關係極為複雜(如影像識別或需要複雜條件分支的數據),基於決策樹的演算法(如 LightGBM、隨機森林等)或類神經網路會有更高的精度。
- 以 L2 正則化為前提: 標準 SDCA 與 L2 正則化(脊迴歸:防止參數過度膨脹的機制)搭配運作。若想進行將不必要特徵量完全歸零排除的 L1 正則化(Lasso迴歸),內部會使用衍生型的 Proximal SDCA 等。
總結: SDCA 迴歸非常適合「數據量極大、不想花時間調整超參數,且希望快速建立具實用精度之預測模型」的情況,是非常強大且易於使用的演算法。
專有名詞解說(摘自 Tera計算 EIQ_AI)
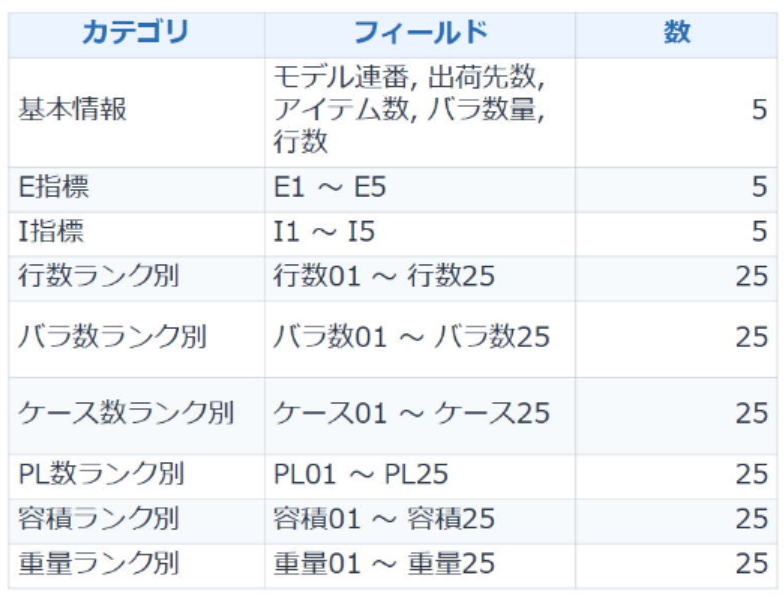
供參考
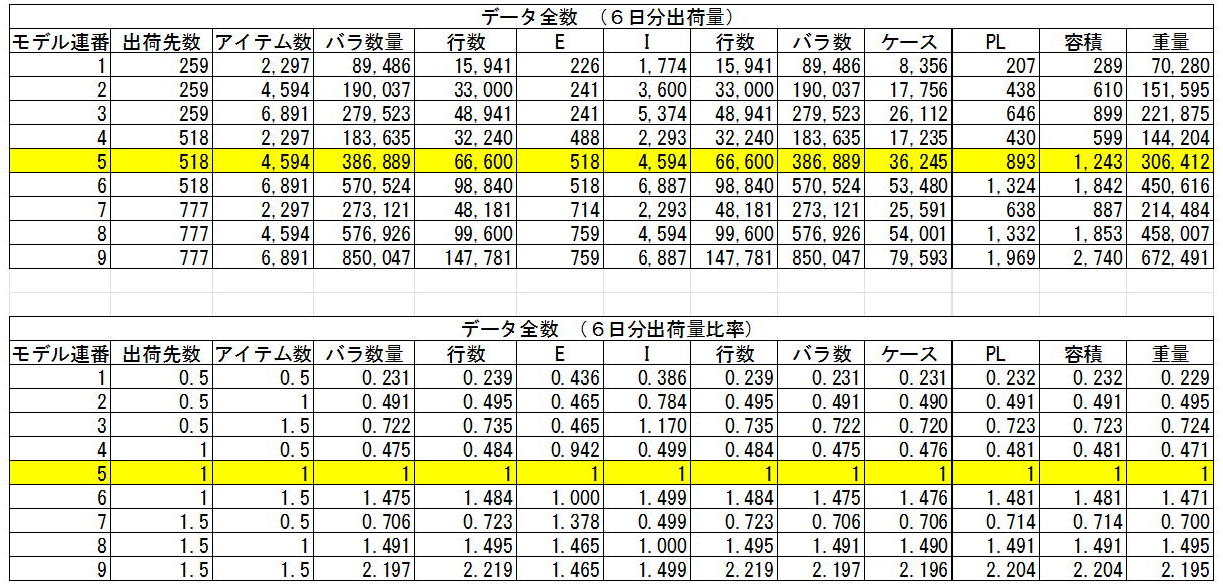
過去教科書常教導「出貨地點數變為2倍且品項數變為2倍時,配送中心規模會變為2倍」,但實際上似乎並非如此。
- 「出貨地點數變為0.5倍且品項數變為0.5倍時,配送中心規模會變為 0.25 倍」。
- 「出貨地點數變為2倍且品項數變為2倍時,配送中心規模會變為 4 倍」。
補充: 這是因為「出貨地點」與「品項」並非單純的加法(+)關係,而是具備乘法(×)的矩陣結構。由於會產生 2倍 × 2倍 = 4倍 的作業組合(揀貨動線或分揀手續等),展現了負荷呈二次曲線增減的物流現場重要法則(碎形波動)。
EIQ分析是從物流中心的「E(出貨地點數)」、「I(品項數)」、「Q(數量)」三大要素來掌握作業特性的傳統手法。本系統採用開創性的方法,將過去的出貨數據實績(EIQ)交由物流AI學習,進而能物流模擬「若出貨地點或品項數增減,現場的作業量與數據會發生何種變化」。